¡Agentes, Agentes, Agentes!
Parte 1 de 3
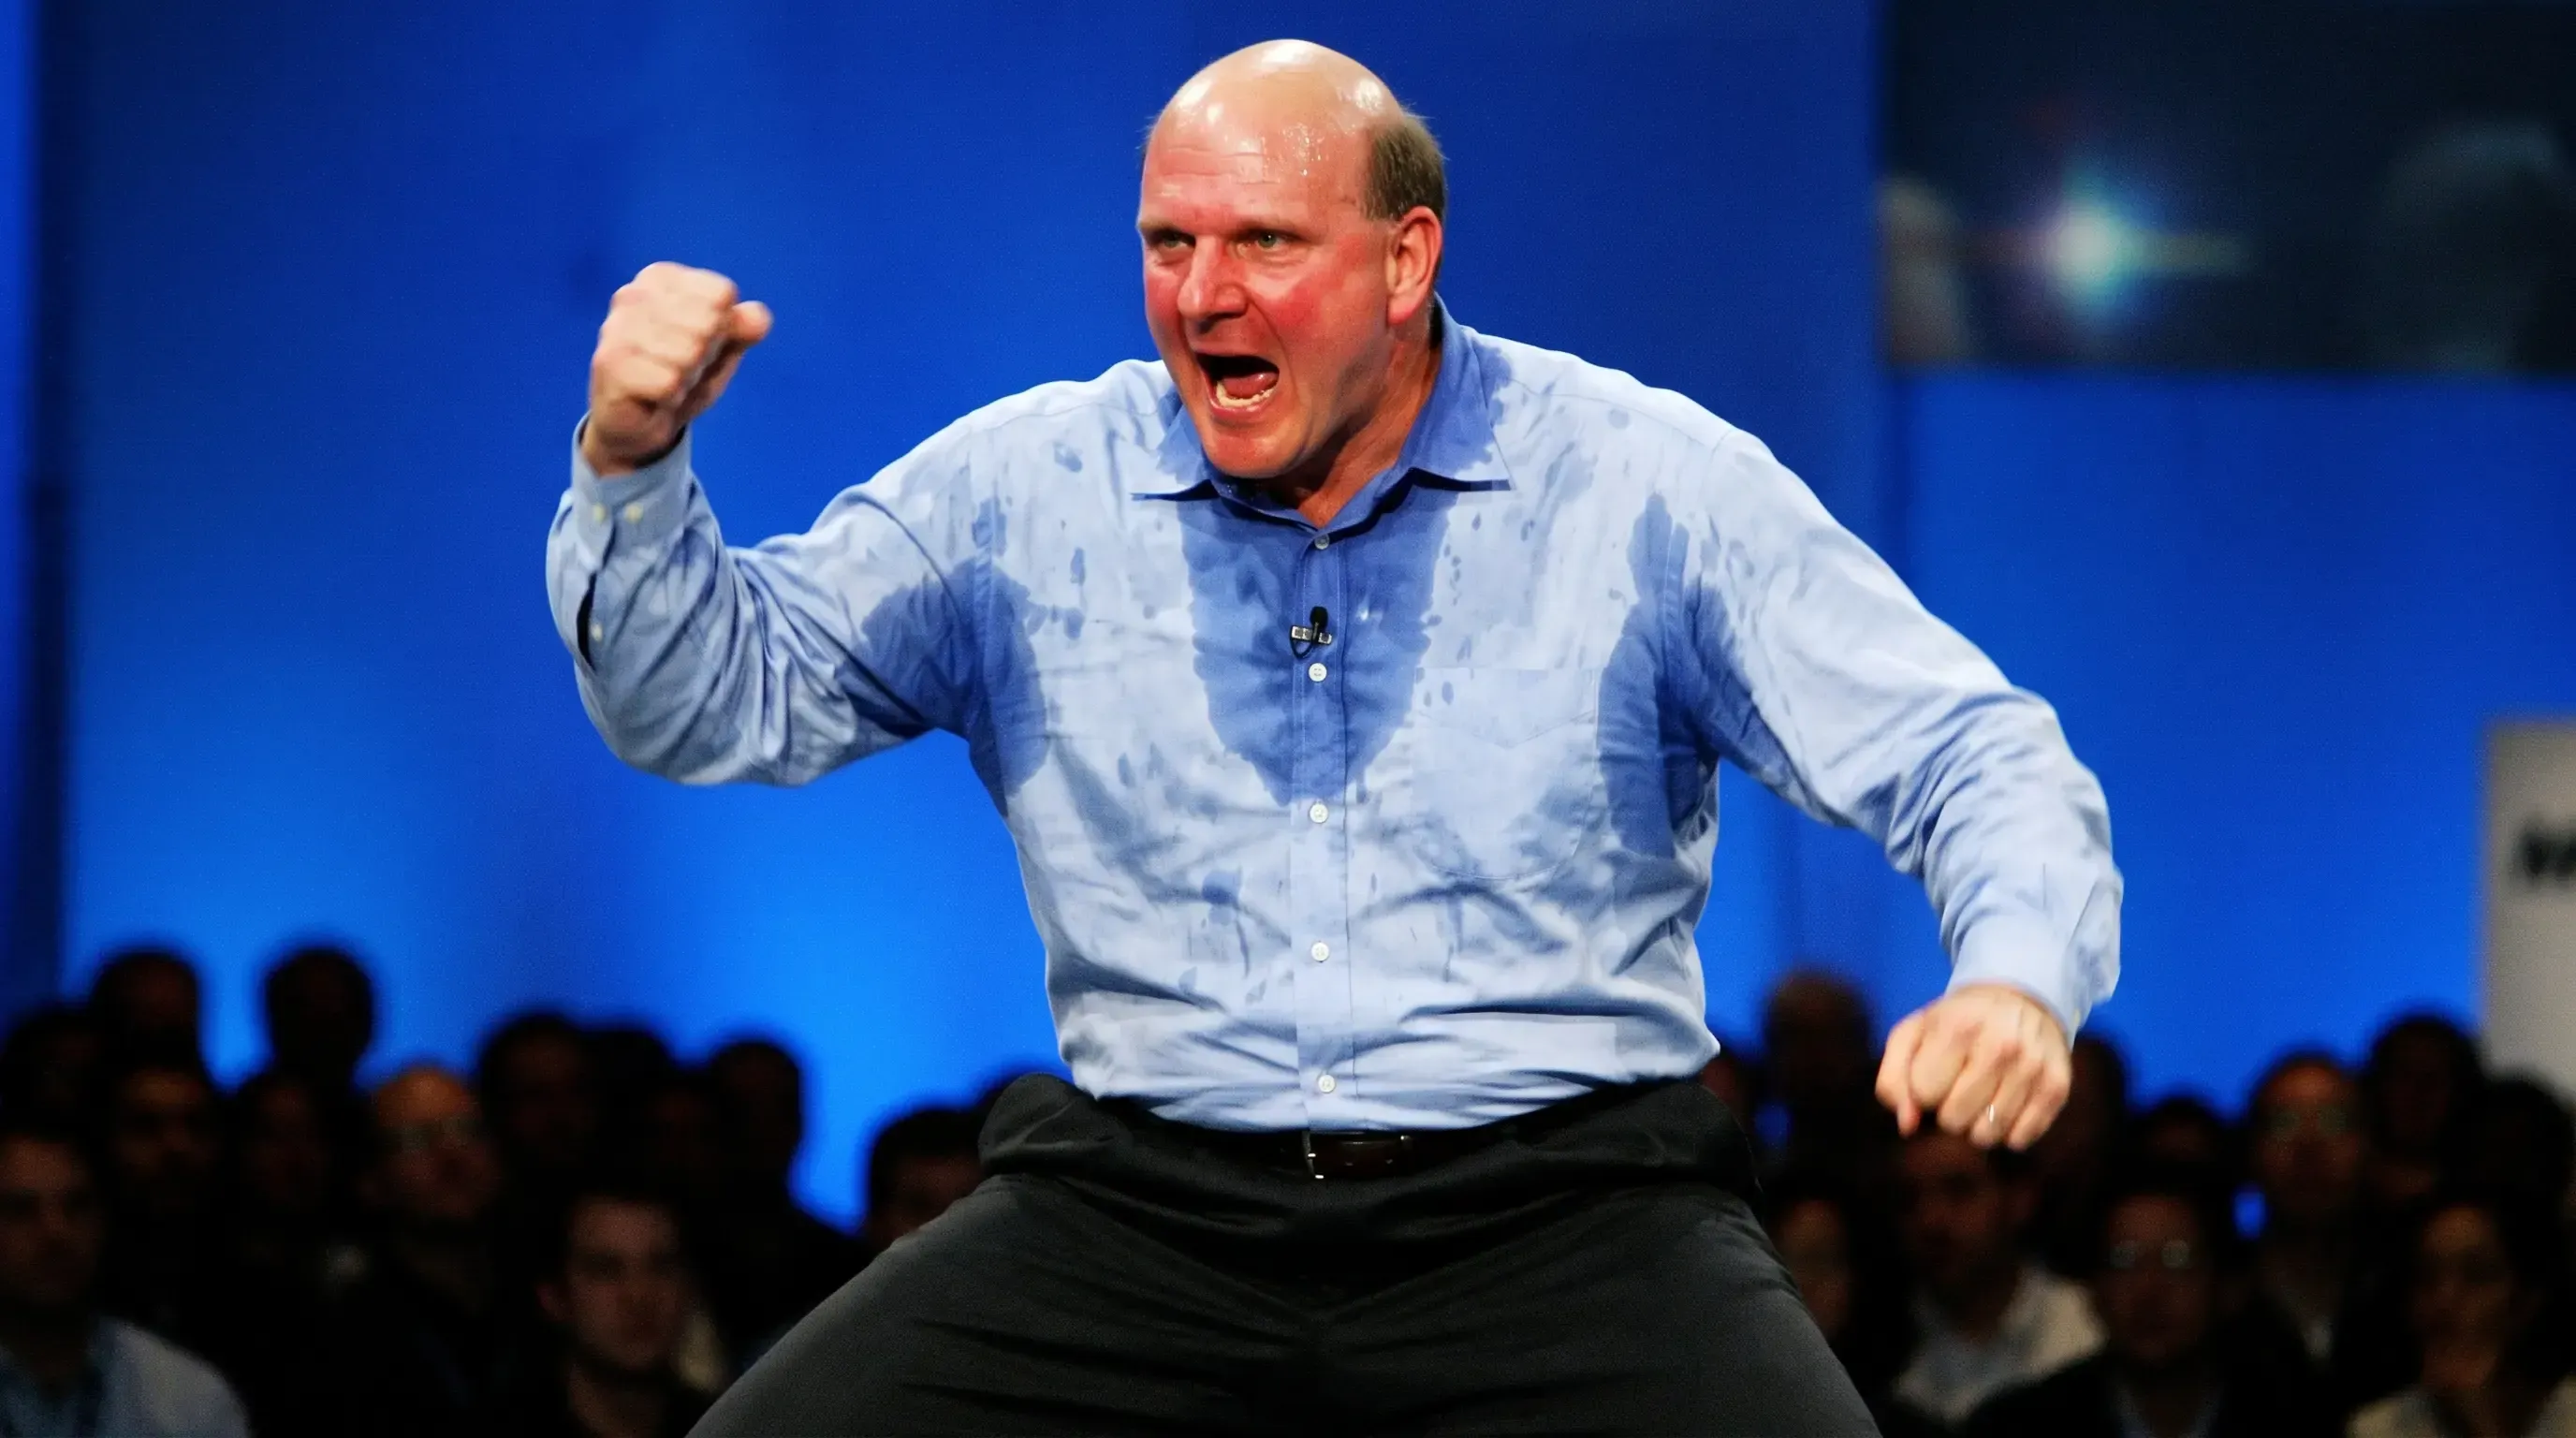
De Ballmer gritando “developers” en el año 2000 a la fiebre actual de los agentes de IA: qué dice la historia académica, y cómo lo están implementando Claude, Copilot y Gemini.
Sección titulada «De Ballmer gritando “developers” en el año 2000 a la fiebre actual de los agentes de IA: qué dice la historia académica, y cómo lo están implementando Claude, Copilot y Gemini.»por Camilo — Octubre 11 2026 · LinkedIn
Septiembre de 2000. Steve Ballmer, recién asumido como CEO de Microsoft, sube al escenario de la Windows 2000 Developers’ Conference empapado en sudor y grita “¡developers!”, seguido, “¡developers!” y luego lo hace 12 veces más, saltando como si estuviera alentando a su equipo en un estadio de fútbol. Porque, en cierto modo, estaba alentando a su propio equipo: Microsoft llevaba años actuando como “solo una empresa de plataformas”, y Ballmer necesitaba que toda la organización — no el público, la propia Microsoft — entendiera que sin un ecosistema de terceros construyendo sobre Windows, la plataforma no valía nada frente al avance de Linux.
Minutos antes había planteado “la pregunta de los 64.000 dólares” — un modismo tomado de un concurso televisivo de los años 50, sinónimo de “la pregunta del millón” — para introducir el tema que de verdad le importaba: la estrategia .NET, la gran apuesta de Microsoft por atraer desarrolladores ‘externos’.
Lo que Ballmer buscaba, en el fondo, no era solo entusiasmo arriba del escenario — era construir, a fuerza de voluntad corporativa, una comunidad de desarrolladores alrededor de .NET. Algo que Linux traía incorporado desde su nacimiento: nació en 1991 como un proyecto colaborativo, construido por y para una comunidad abierta. .NET tenía que fabricar esa comunidad desde cero, compitiendo contra una que ya existía por diseño.
Veinticinco años después, se puede reconocer un patrón parecido en el desarrollo de las herramientas de IA. Los jugadores principales — Claude, Copilot, Gemini — llegaron rápido a una conclusión similar: no alcanza con tener un modelo potente, hace falta ponerle a la comunidad de desarrolladores herramientas realmente “usables” alrededor de ese modelo. Ahí es donde entran los agentes en escena — y cada empresa los está implementando de una forma distinta, con decisiones de arquitectura que vale la pena entender antes de elegir con cuál construir.
Los agentes no nacieron con ChatGPT
Sección titulada «Los agentes no nacieron con ChatGPT»La palabra “agente” tiene una definición académica formal que es treinta años más vieja que la fiebre actual. En 1995, Michael Wooldridge y Nicholas Jennings publicaron Intelligent Agents: Theory and Practice, el paper que fija la definición que todavía se usa hoy: un agente es un sistema que percibe su entorno, decide de forma autónoma y actúa sobre ese entorno para cumplir un objetivo. No hace falta un modelo de lenguaje para eso — los agentes de software, los sistemas multiagente y la robótica venían trabajando con esta definición desde mediados de los 90, mucho antes de que existiera un LLM capaz de sostener una conversación.
Ahí está el primer punto que conviene no perderse: la IA generativa no inventó el concepto de agente, lo heredó. Y lo heredó con una condición que ya veníamos discutiendo en este blog a propósito de otro tema. Cuando hablamos de que el modelo no es el producto, la idea central era que un LLM es el motor, no el auto — lo que determina qué puede hacer un producto es todo lo que se construye alrededor: system prompt, RAG, tool calling. Con los agentes pasa exactamente lo mismo, un escalón más arriba: el modelo tampoco es el agente. Un LLM, por más grande que sea, sigue siendo una pieza que predice el siguiente token. Lo que lo convierte en algo que se comporta como un agente — que percibe, decide y actúa sobre un entorno real — es el harness que lo rodea, no el modelo en sí.
El primer paper que formaliza ese harness para LLMs es ReAct (Yao et al., 2022), que propone el patrón que hoy es la base de prácticamente todo agente basado en modelos de lenguaje: razonar, actuar, observar el resultado, repetir. Antes de ReAct, un LLM generaba una respuesta y se terminaba la interacción. Después de ReAct, un LLM podía generar un pensamiento intermedio, ejecutar una acción sobre el mundo, leer lo que pasó, y ajustar su siguiente paso — el mismo loop que hoy llamamos “agentic loop” sin pensar demasiado en que tiene un origen puntual y fechado.
Unos meses después, Toolformer (Schick et al., 2023) resuelve una pieza más del rompecabezas: hasta ese momento, que un modelo usara una herramienta externa dependía de que el wrapper alrededor del modelo decidiera cuándo llamarla. Toolformer muestra que el propio modelo puede aprender a decidir cuándo necesita una calculadora, un buscador o una API, sin que un desarrollador externo programe esa decisión a mano. Es la versión agéntica del tool calling que ya conocíamos de los productos de IA tradicionales — mismo mecanismo, pero ahora la decisión de uso vive adentro del modelo, no en la capa de arriba.
2023 también trae el momento bisagra cultural: AutoGPT y BabyAGI, dos proyectos de código abierto que proponían algo tan simple como seductor — dale un objetivo de alto nivel a un LLM con acceso a herramientas y dejalo iterar solo hasta cumplirlo. Ninguno de los dos es un paper académico ni resistió bien la prueba de producción (los loops se descarrilaban, el costo en tokens se disparaba, la fiabilidad era baja), pero fueron el disparador que instaló “agente autónomo” en el vocabulario de cualquiera que mirara tecnología, meses antes de que la industria tuviera un estándar sólido para construir esto bien.
Ese estándar empezó a tomar forma recién en noviembre de 2024, cuando Anthropic publicó el Model Context Protocol (MCP): un protocolo abierto para que un agente se conecte con herramientas y fuentes de datos externas sin que cada integración se reinvente desde cero. Si un agente es “modelo + harness + herramientas”, MCP ataca específicamente la tercera pieza — y es, como vamos a ver, el punto donde las tres implementaciones que siguen más se parecen entre sí, aunque todo lo demás lo resuelvan distinto.
Claude, Copilot y Gemini: mismo problema, tres respuestas distintas
Sección titulada «Claude, Copilot y Gemini: mismo problema, tres respuestas distintas»Con la teoría ya instalada, la pregunta práctica es cómo se traduce esto en herramientas que usamos todos los días. Tres de los jugadores más visibles — Anthropic, GitHub/Microsoft y Google — están resolviendo exactamente el mismo problema conceptual (modelo + loop + herramientas) con decisiones de arquitectura bastante distintas.
Claude construye su harness alrededor de un loop explícito de cuatro pasos: reunir contexto, actuar, verificar el trabajo, repetir. El Claude Agent SDK reúne contexto con búsqueda agéntica (el agente usa comandos tipo grep para cargar solo lo que necesita de archivos grandes, en vez de indexar todo de antemano), actúa mediante herramientas personalizadas, bash y MCP, y verifica su propio trabajo con chequeos basados en reglas (linting), feedback visual (capturas de pantalla vía Playwright MCP) o subagentes que actúan como jueces del resultado. Los subagentes corren en ventanas de contexto aisladas, en paralelo, y devuelven al orquestador solo lo relevante — una decisión de diseño pensada explícitamente para no saturar el contexto principal con ruido.
GitHub Copilot separa el problema en dos modos con filosofías opuestas. El agent mode, dentro del IDE, es síncrono: ves al agente razonar y actuar en tiempo real, con acceso a todo el workspace, mientras vos seguís ahí mirando y podés frenarlo o redirigirlo en cualquier momento. El coding agent (antes “cloud agent”) es asíncrono: le asignás una tarea desde GitHub.com, un issue o un comentario de PR, y el agente trabaja solo en un entorno efímero corrido sobre GitHub Actions, con un límite duro de 59 minutos por sesión, hasta abrir un pull request para que lo revises vos. Ambos modos soportan MCP, pero la decisión de diseño central de Copilot no pasa por el loop interno — pasa por cuánto control en tiempo real le cedés al agente.
Gemini, a través de Antigravity (lanzado en noviembre de 2025 junto con Gemini 3), apuesta directamente por la orquestación múltiple como eje central: tiene una vista de editor tradicional y una vista de “manager” pensada para correr varios agentes en paralelo sobre distintos workspaces, cada uno produciendo entregables verificables — planes de tarea, capturas, grabaciones de navegador — que un humano revisa después, no durante. También soporta MCP como estándar abierto de conexión de herramientas, y además permite enchufar modelos de Claude u otros, no solo Gemini.
| Claude | GitHub Copilot | Gemini / Antigravity | |
|---|---|---|---|
| Eje de diseño | Loop explícito: contexto → acción → verificación | Dos modos separados: sync (editor) vs. async (cloud) | Orquestación multi-agente en paralelo |
| Paralelismo | Subagentes en contexto aislado | No dentro de un mismo modo | Nativo, vía vista “manager” |
| Control humano | Verificación integrada al loop | Total en agent mode, por revisión en coding agent | Por revisión de entregables, al final |
| MCP | Sí, nativo | Sí | Sí |
Ningún enfoque es objetivamente superior — son respuestas distintas a la misma pregunta de diseño: ¿cuánta autonomía le das al agente antes de que un humano mire lo que hizo? Claude apuesta a verificar adentro del loop; Copilot te deja elegir entre mirar todo o nada; Antigravity asume que vas a revisar varios agentes a la vez, no uno en tiempo real.
La pregunta ya no es si, es cómo
Sección titulada «La pregunta ya no es si, es cómo»Lo que cambió entre el grito de Ballmer en 2000 y el de la industria hoy no es la urgencia — es la naturaleza de lo que se está pidiendo construir alrededor. Ballmer necesitaba desarrolladores externos construyendo sobre una plataforma. La industria de IA hoy necesita harnesses bien diseñados construyendo sobre un modelo. El patrón de fondo es el mismo que venimos repitiendo en este blog: la capacidad cruda nunca es el producto terminado, y con agentes esto se vuelve todavía más evidente, porque la diferencia entre “un LLM que responde” y “un agente que resuelve” no está en qué tan grande es el modelo, sino en qué tan bien diseñado está el loop, las herramientas y los chequeos de verificación a su alrededor.
En la próxima entrega de la serie bajamos específicamente a cómo se arma eso en Claude: subagentes, Skills, MCP, hooks, granularidad de funciones y los criterios para calibrar cuándo un agente está bien diseñado y cuándo es solo un wrapper frágil disfrazado de autonomía.